PDF 阅读 · LaTeX / Tavotto 图源与数据 · 完整 query 整理版 · 实测统计 CSV
给 Agent 一个端子模型和两步加载要求,它能否检查模型、安排计算资源、完成求解,再交回可核对的曲线与云图?这个项目把 HyperMesh、Abaqus 和 ParaView 连接为三个 MCP 服务,在一个真实端子接触案例上跑通了这条链路。三组独立实测均完成两步计算;启用 MCP 与工程规程的一组耗时 21.82 分钟,得到 108 帧结果与约 1.434141 N 的驱动力峰值。
从一句工况描述开始
传统 CAE 自动化通常从一段脚本开始:导入模型、定义集合、提交作业、提取结果。Agent 让脚本生成变得容易,但工程任务的难点往往出现在脚本之外:口述里的“右端”对应哪个区域,应用进程退出是否意味着求解成功,外推节点应力能否与积分点应力直接比较,失败后改了什么,以及下一步究竟应该读取哪个文件。
我把这些问题作为工具接口的一部分。Agent 解释目标并选择动作;工具检查输入、调用原生应用、保存日志并返回实际产物。本文重点是执行的可靠性和可追溯性,数值结果均来自已完成的工程任务,测量日期为 2026 年 10 月 12 日。
端子案例的要求可以概括为:保留已有材料、截面与网格,固定 male 根部和 shield 根部,plate 先沿全局 预压 ,再与 female 一起沿全局 移动 ,摩擦系数为 0.13。这里的位置、方向和集合均经过确认。对新的“左边”“向下”等模糊描述,先展示候选区域与坐标解释,确认后再修改工况。
三个 MCP,54 个工具
MCP 提供 Agent 调用工具的协议。这个项目按应用分成三个服务,共用执行底座:HyperMesh 负责几何和网格,Abaqus 负责模型、求解与 ODB,ParaView 负责结果检查和可视化。
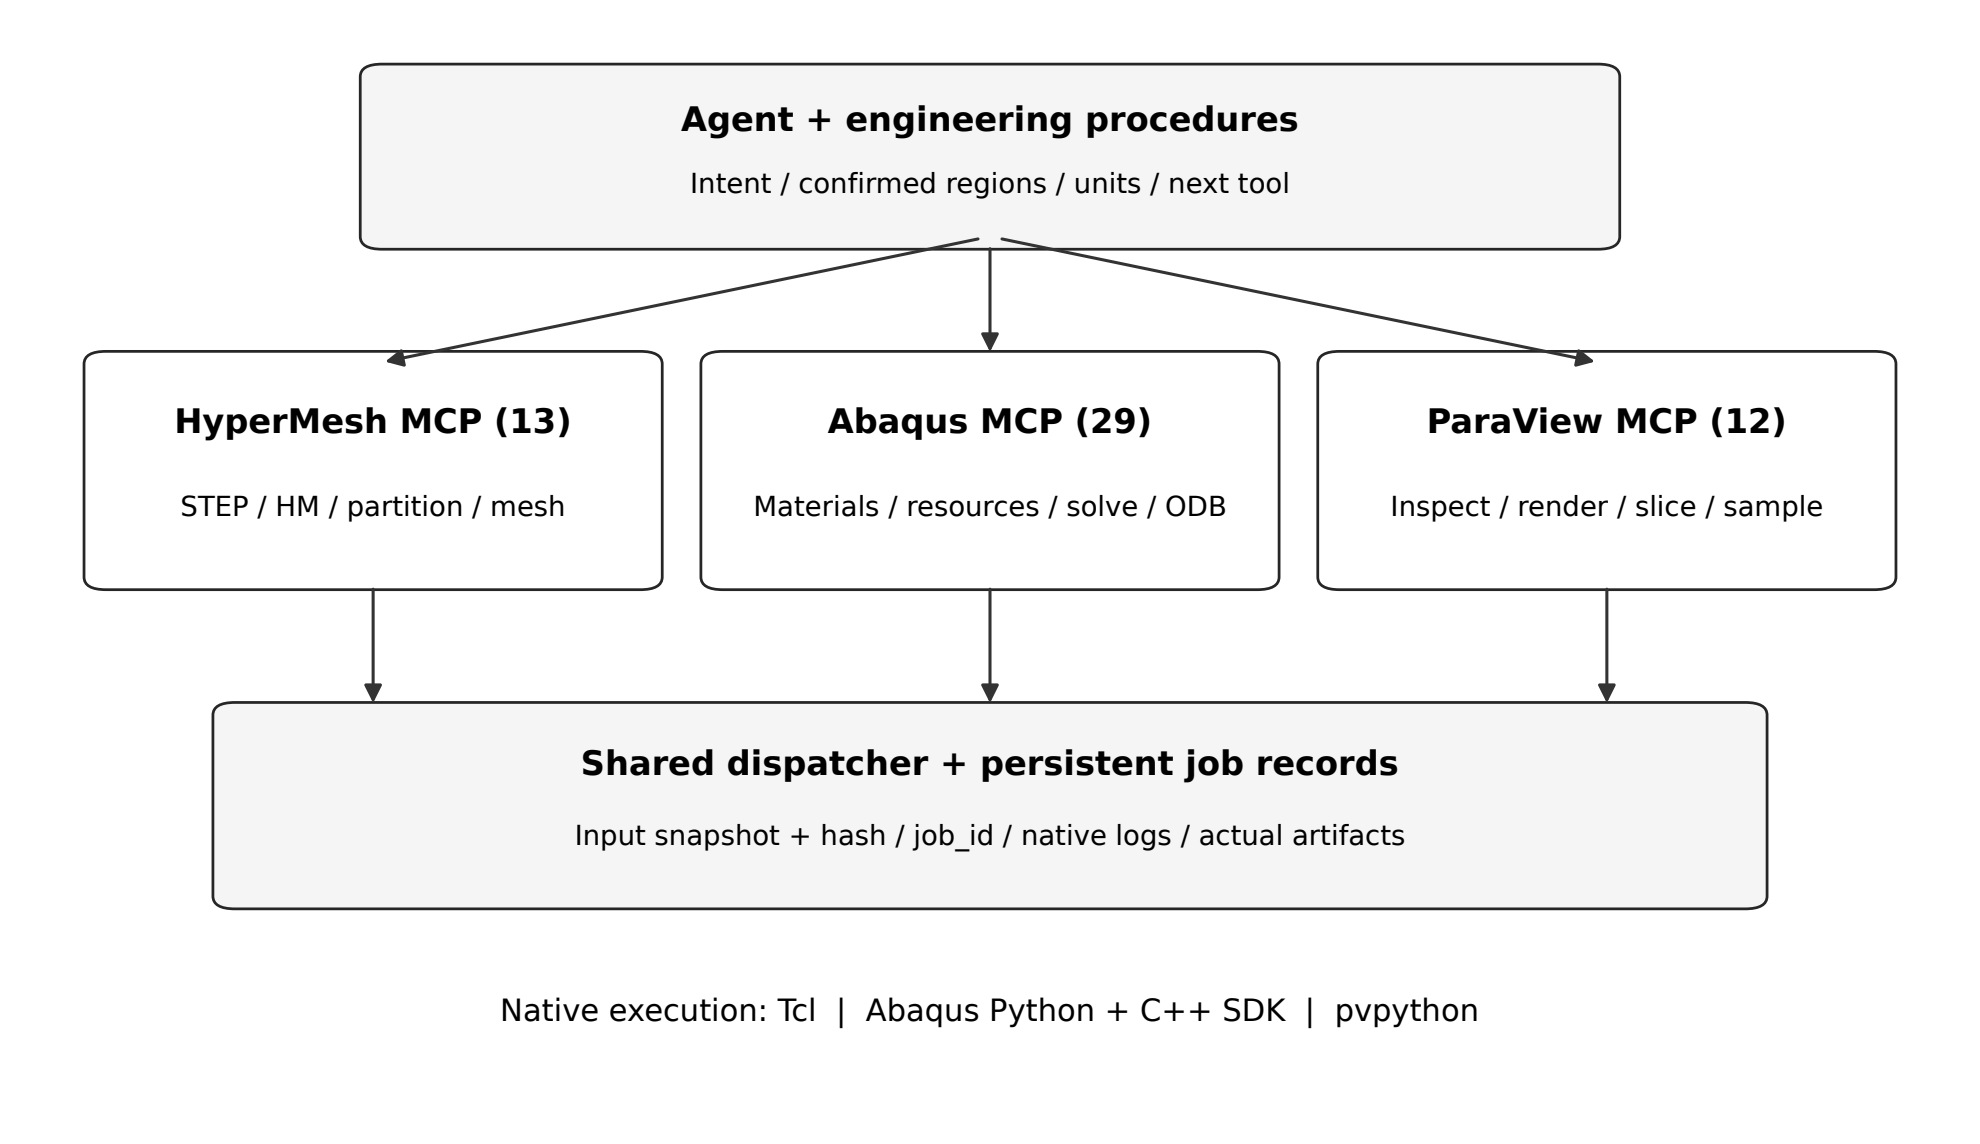
| 服务 | 工具数 | 能力 |
|---|---|---|
| HyperMesh | 13 | STEP 导入、HM 检查、平面切分、四面体网格、Abaqus INP 导出和高级 Tcl。 |
| Abaqus | 29 | 材料与截面库、区域检查、工况准备、资源计划、提交求解、错误诊断、修复、ODB 检查及转换。 |
| ParaView | 12 | 数据数组与帧检查、渲染、切片、线采样、图片返回和高级 Python。 |
每个服务包含六个通用工具:能力检测、任务状态、任务列表、产物列表、日志读取和取消。因此 54 是工具总数,包含按服务提供的通用管理接口,不能理解为 54 种独立求解算法。完整清单随文章源码提供。
应用脚本在各自的运行环境执行:HyperMesh 2017 使用 Tcl;Abaqus 2025 使用自己的 Python 或 C++ SDK;ParaView 6.1 使用 pvpython。普通 Python 服务处理协议、排队和输入检查,避免直接混用商业软件的二进制 API 与解释器。
为什么保留三个 MCP?因为几何、求解和后处理有不同的输入契约、运行时和失败方式。资源管理则放进 Abaqus 服务,避免多个服务分别计算、重复占用同一份求解预算。独立 ODB2VTK 也可以绕过 MCP 直接使用。
长任务需要持久状态与实际文件
工具受理一个长任务后返回 job_id,而非阻塞到求解结束。后台 dispatcher 独立管理执行进程,客户端通过状态工具继续跟踪。只有任务进入 succeeded,才能把返回的真实产物路径交给下游;queued 和 running 都不表示完成。
每次任务保存请求、设置快照、原生脚本、日志、状态和结果索引。INP 依赖的 INCLUDE 文件递归复制,并记录 SHA256。资源计划也绑定输入闭包;排队期间源文件变化时,原计划不能静默用于新的输入。源模型保持只读,修复和重试产生新文件。
Abaqus 的完整成功检查同时要求原生完成标记、两步到达指定终点,以及非空、已关闭的新 ODB。ODB 文件存在,或者某个增量收敛,都不足以说明完整任务完成。ParaView 还要核对真实数组、帧数和取值范围,不能只交一张看起来合理的图片。
Windows 上还有进程生命周期问题:客户端退出可能连带结束其子进程。独立 dispatcher 的意义是让已经受理的求解不依附于一次工具调用的连接寿命。它承担本地执行管理,不替代操作系统或集群调度器。
把 ODB 转换做成独立的 C++ 工具
ODB2VTK 使用 Abaqus 官方 C++ ODB API,通过 bulkDataBlocks() 连续读取字段,避免逐个 FieldValue 对象访问。网格、节点标签映射和 section assignment 只构造一次,跨帧复用。输出采用二进制 VTU,并用 PVD 索引选定帧。
命令行支持 inspect、menu 和 convert。未显式指定时,从 ODB 检测最后一个有帧的分析步、末帧、所有非空实例,以及存在的 U 和 S:MISES。也能选择多个分析步、帧列表或范围、section point、输出位置、变形倍率和复数实部或虚部。
.\native\odb2vtk\odb2vtk.cmd inspect --odb "input.odb"
.\native\odb2vtk\odb2vtk.cmd menu --odb "input.odb"
.\native\odb2vtk\odb2vtk.cmd convert --odb "input.odb" --step all --frames all --fields "U,S:MISES" --avg 75 --regions section --output "exports\terminal"
转换结果包含逐帧 VTU、collection.pvd 和 manifest.json。ODB 按只读打开,缺失值保留 NaN,未知单元默认报错,旧 ODB 不会被隐式升级。Windows 启动器负责设置当前进程的 Abaqus DLL 搜索路径;迁移机器时仍需匹配的原生运行库。
Avg 75 的关键是区域和计算顺序
依照 Abaqus/CAE 的默认区域定义,这里的平均区域是实际 section assignment,不是仅按材料名或 section 名合并。两个 assignment 即使引用相同 section,也保留各自边界。缺少 assignment 的单元被隔离并报告,避免猜测连续区域。
对 Mises 等标量,处理顺序是:外推张量到单元节点,计算标量,再按区域和阈值决定是否平均。对某一节点的有效贡献值,差异百分比定义为 其中分母取当前平均区域内全部有效外推值的范围,分子取该节点的贡献范围。在非退化区域内, 时做等权平均;等于阈值时保留不连续值。区域范围为零且贡献相等时,正阈值允许平均。阈值为 0 或 off 则关闭平均。
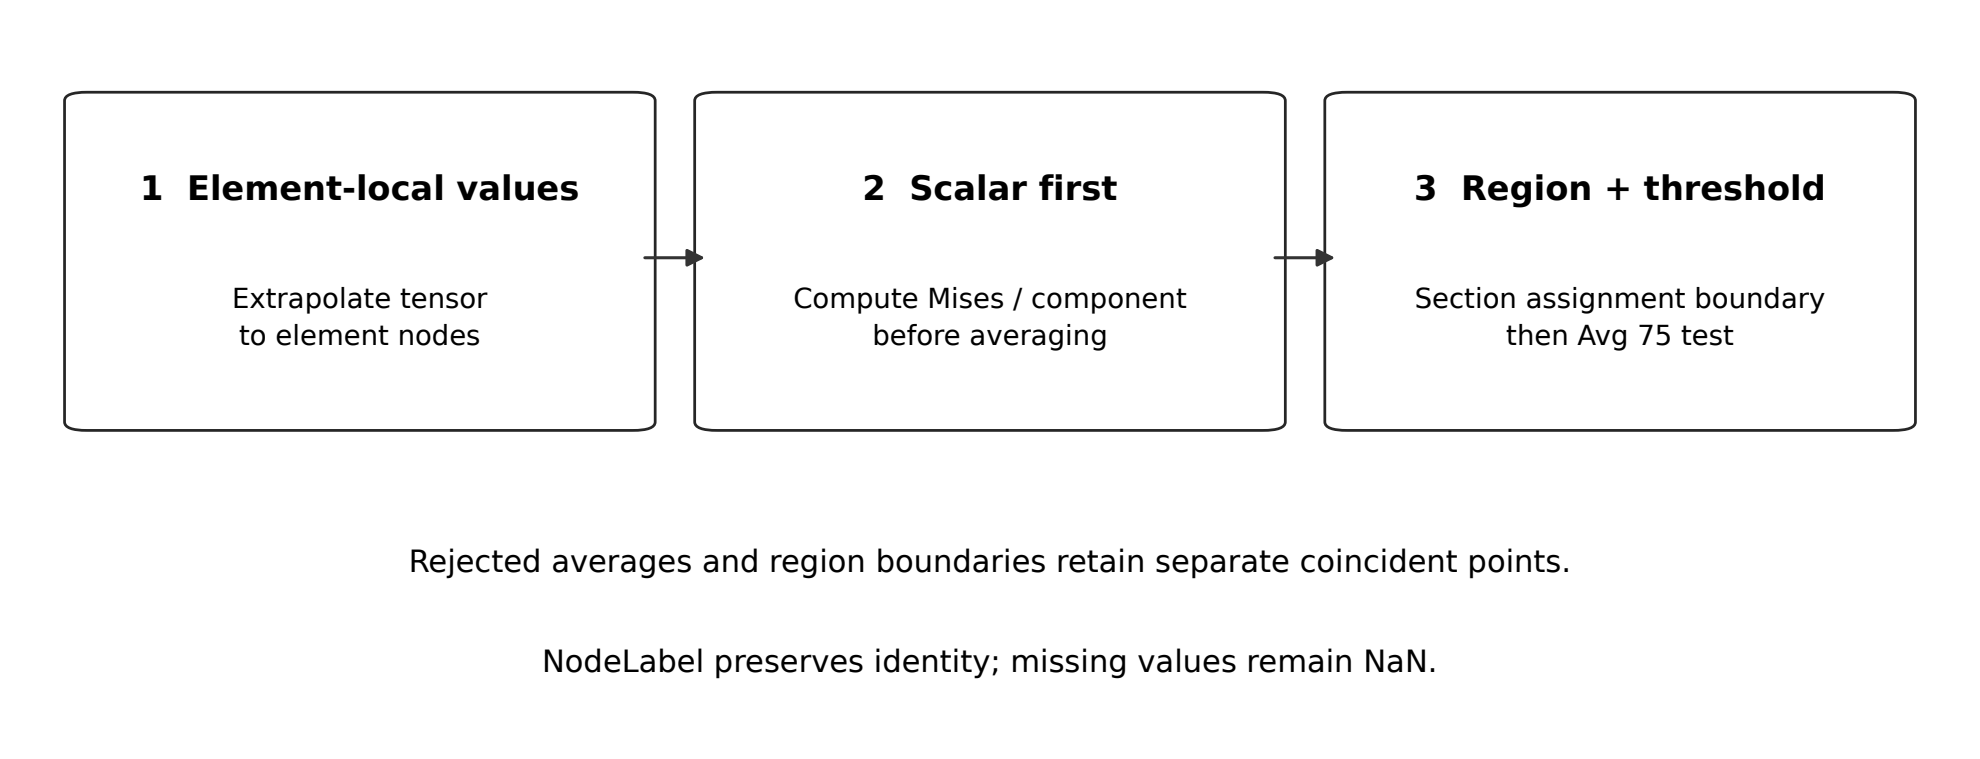
结果数组包括 S_MISES_Avg、差异百分比、是否实际平均以及 SectionAssignmentId。后处理阶段不再插入 Clean/Merge Points,也不额外做 Cell Data to Point Data,避免抹去导出时保留的边界。
这实现了 section assignment 下的 scalar-before-average;壳/膜 feature-edge 附加边界和 tensor-after-average 模式没有在这里复刻。积分点结果与外推节点显示值也必须分开:同一末帧的原积分点最大 Mises 为约 644.00 MPa,而 Avg 75 外推节点显示峰值约为 1355.07 MPa,两者不是同一个测量位置。
计算资源如何自动选择
资源工具先扫描 INP、INCLUDE 和装配实例,读取节点数、单元类型、分析过程、接触和 NLGEOM。重复实例按实际装配规模计数。对本例实体网格,用 作为自由度规模代理;存在接触时乘以 1.5,得到加权规模 。它不是约束消元后的真实方程数。
CPU 基础档位为 最终档位还受物理核、项目预算、用户限制和已配置的许可证额度约束。内存上限按规模采用 15%、30%、50% 档位,并结合可用内存和共享预算裁剪。abaqus_plan_resources 只生成计划,abaqus_submit_job 消费计划并在启动时再次核验。
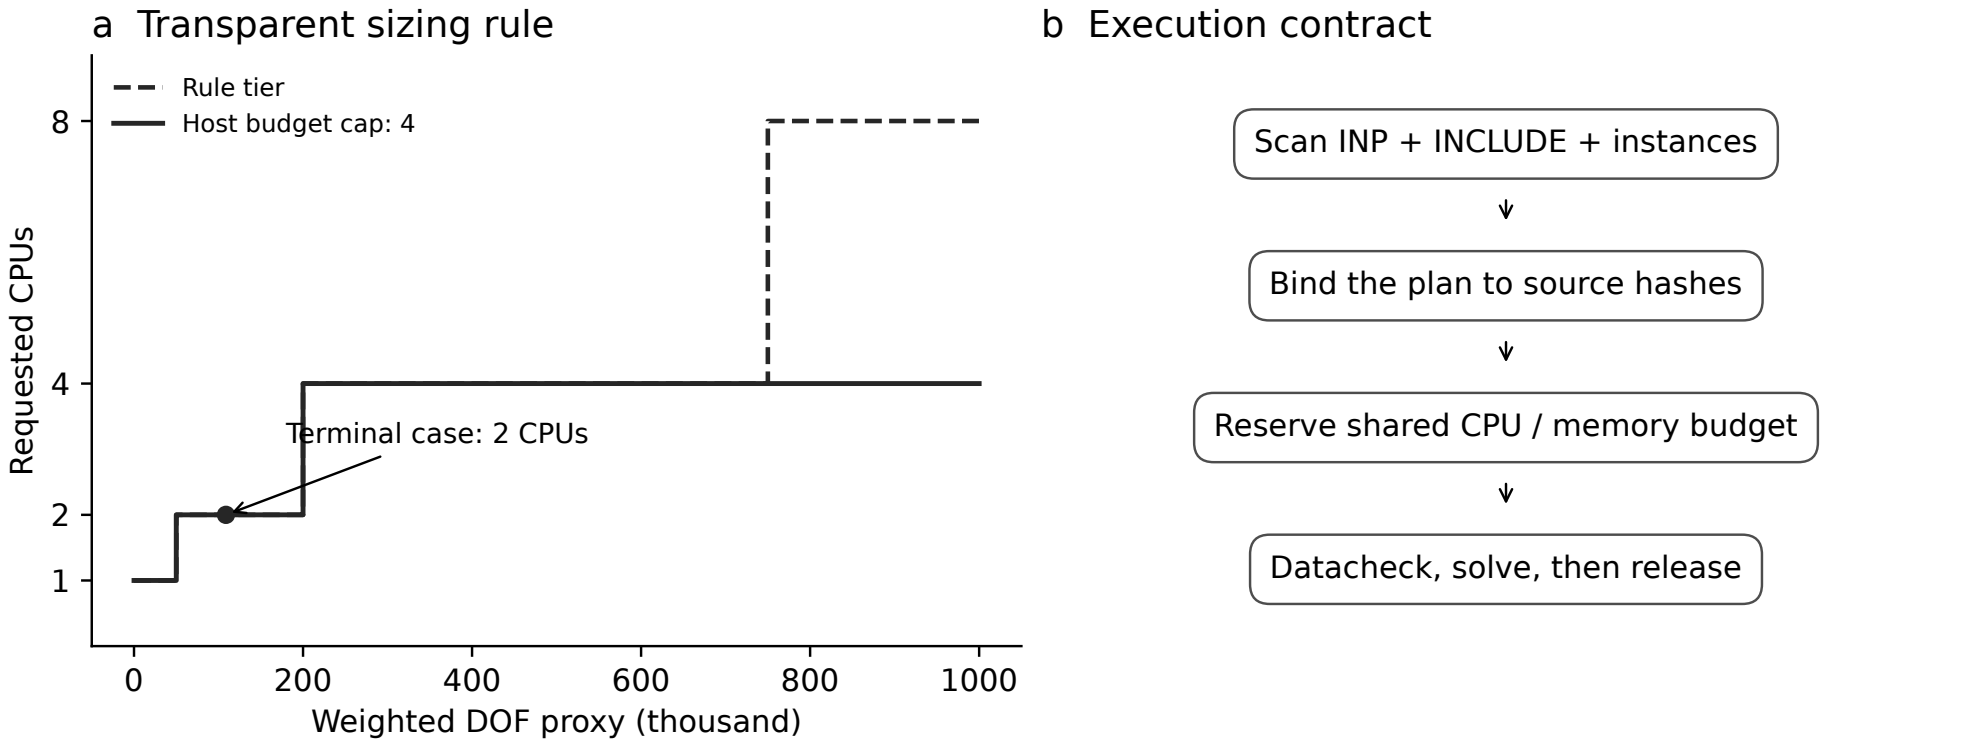
本例选取 2 CPU、15% 内存上限。比较实验也给所有组相同的上限,使用纯线程配置,避免把资源差异混入工具比较。共享预留保证本工具启动的并发求解满足 CPU 和内存总预算;预算不足则排队,任务结束后释放。
这是一套透明、可解释的初始分配规则,还没有通过多规模、多 CPU 档位的重复实验寻找最优值。根据 Abaqus 作业参数定义,Standard 的 memory 是可分配上限;Explicit 分析阶段的实际内存也不能按同一个参数理解。系统不接管外部启动的求解,也没有把配置中的许可证上限冒充为实时许可证池查询。
报错以后,先读证据,再生成新输入
abaqus_diagnose_job 读取真正的 .dat、.msg、.sta 和日志,返回有界原文、文件哈希、分类以及适用的修复动作。未知错误保留未知,不凭关键词猜一个“万能修复”。
abaqus_repair_job 的自动范围刻意收窄:在有诊断依据时降低初始静力增量或提高最大增量数,保存新 INP、差异和修改清单,再做资源计划与 datacheck。它不改变总载荷、材料、摩擦、固定位置或总步长。涉及物理条件的改动仍需明确确认。
端子产品组第一次 datacheck 实际遇到的是空节点面定义。Agent 根据原生日志确认该空 surface 未被使用,通过高级脚本注释该定义、移除一处空行,保留修改差异,再通过检查并完成求解。这次修复体现的是诊断工具与原生脚本协作,不能把它描述成受限数值修复工具已经覆盖所有语法问题。
材料与截面库,以及 Skill 的位置
已有材料可能来自 INP、CAE 或 HyperMesh 模型。库工具采用“提取预览、再提交”的方式导入,保存原始 keyword、声明单位、来源和修订记录。更新记录时要求 expected_revision,截面引用指定材料修订,避免一次覆盖让历史任务失去原参数。导出时再把库内定义绑定到明确的 ELSET;单位不会被静默换算。
现有四面体工况模板支持其定义范围内的均质实体截面。复合截面、未知 keyword 或无法解析的方向定义会拒绝或报告遗漏。本文端子模型沿用原材料与截面,未为其补造演示弹性参数。
Skill 解决的是编排规程:先检查单位和集合,遇到模糊空间描述先确认,等待长任务成功,再使用实际产物,保持平均边界,解释原生警告,并保留失败尝试。它让 Agent 更稳定地使用已有工具;确定性校验仍留在 MCP 内,避免只靠提示词维持正确性。对比中的产品组同时启用了 MCP 和工程规程,实验没有单独隔离 Skill 的贡献。
端子案例:从模型检查到后处理
输入是一份已有网格的单对端子 INP,以及从整体装配提取的 HM 伴随模型。一件 female 对两片 male,另含 shield 与 prepress plate。INP 是网格编号、材料、截面及八对接触定义的权威来源,HM 用于原生模型检查;两者的节点编号不互相替代。
模型有 11,240 个 C3D10M 单元。male 根部两个集合各 21 个节点,shield 根部 159 个节点,共固定 201 个根部节点。female 通过 72 个节点的控制区域与 RP 耦合;plate 节点面含 1061 个节点,并耦合到独立 RP。
| 设置 | 数值或定义 |
|---|---|
| Prepress | plate 的 mm,;female 保持不动。 |
| Insertion | 保持 plate 的 ;plate 与 female 同步 mm。 |
| 接触 | 摩擦系数 0.13,硬接触,有限滑移,NLGEOM=YES。 |
| 静力控制 | 两步初始增量 0.01,总步长 1,最小增量 ,最大增量 0.05,最大增量数 10000。 |
| 其余约束 | RP 转动和未驱动平移分量保持固定;male 与 shield 根部平移固定。 |
执行顺序为:HyperMesh 检查伴随模型,核对 INP 网格与区域,生成两步新输入,创建资源计划,运行 datacheck,处理真实报错,再提交完整求解。完成后直接读取新 ODB 的控制点 history、能量和原积分点结果,再转换全部分析步和帧,由 ParaView 核对并渲染。
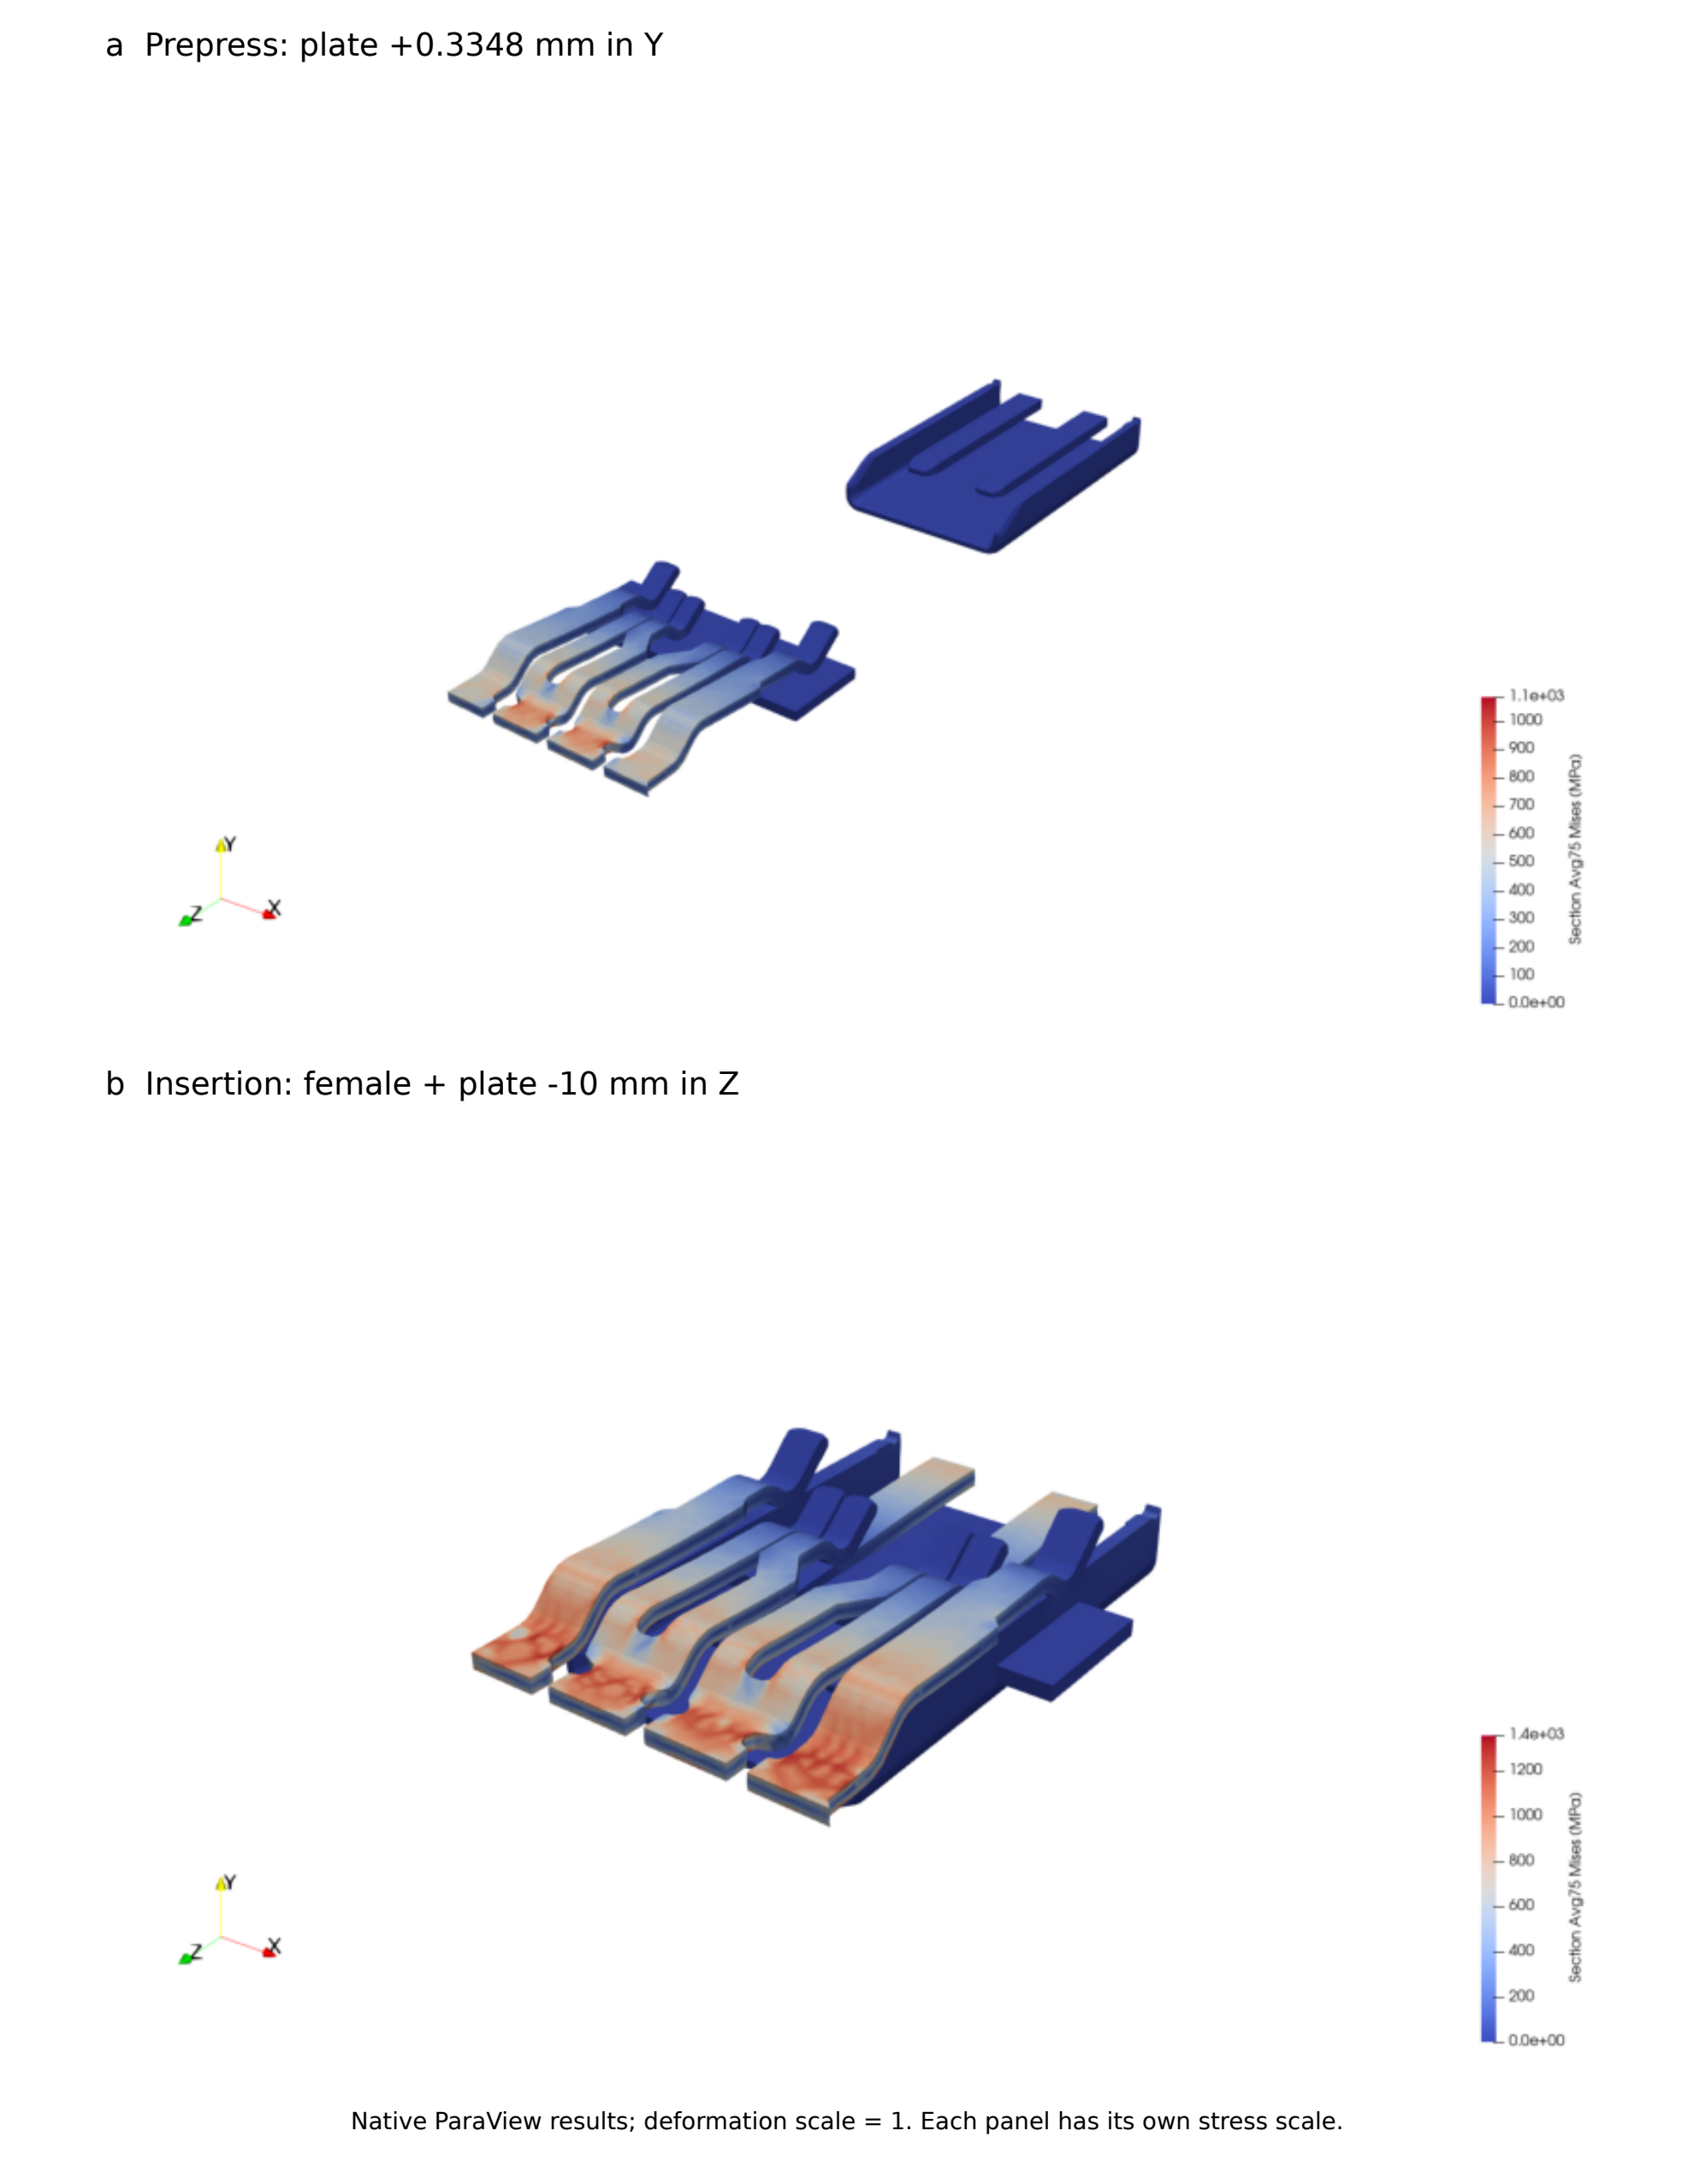
这里保留已有网格,前处理完成的是模型检查、区域核对、耦合与加载准备。工具链具备 STEP 导入、几何切分及四面体网格功能,但本例没有以 CAD 自动重划网格并重建全部接触作为实测起点。两步也只包含预压与插入,没有另行添加拔出。
用数值定义结果
驱动力取两个运动 RP 的全局反力,投影到插入方向: 这避免把接触两侧的内部力重复相加。产品组的新 ODB 包含 25 个 Prepress 帧与 83 个 Insertion 帧,共 108 帧;两步均达到终点,控制位移与给定值一致。
| 指标 | 数值 |
|---|---|
| 预压终点 plate (mm) | 0.334800005 |
| 插入终点 female / plate (mm) | |
| 驱动力峰值(N) | 1.434141 |
| 终点驱动力(N) | 0.974671 |
| 末帧原积分点最大 Mises(MPa) | 644.000061 |
| 末帧最大 PEEQ | 0.009152083 |
| 末帧全储存 RF 三分量余额最大绝对值(N) |
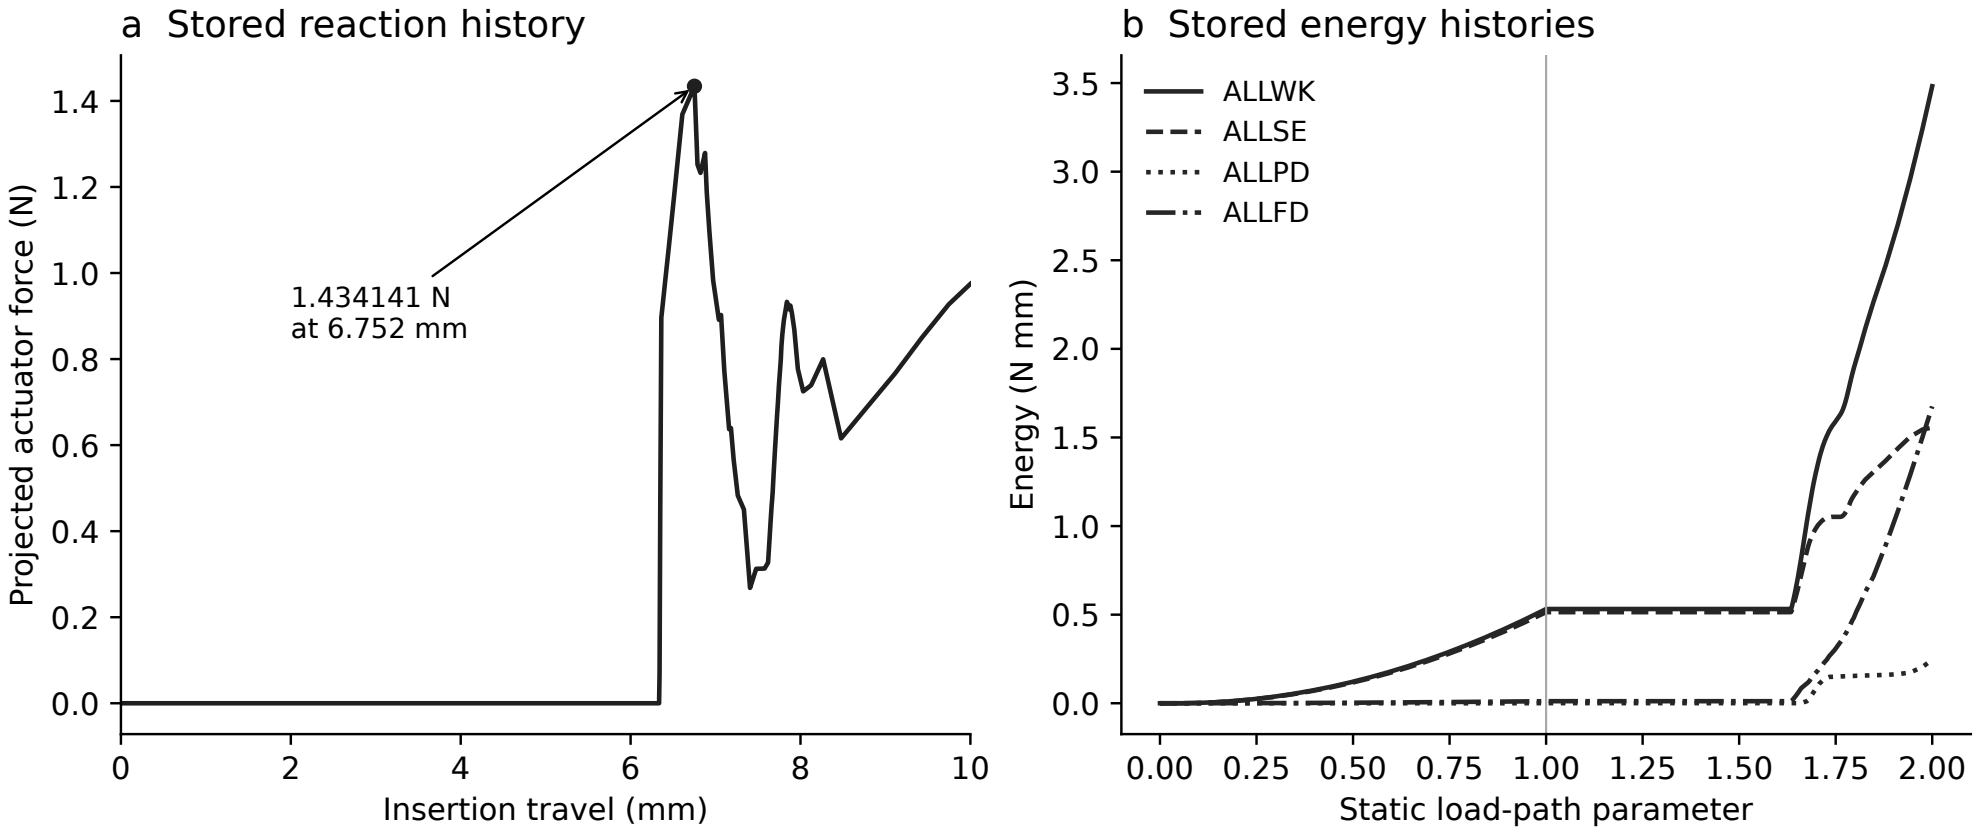
所选末帧能量项为 ALLWK 约 3.4821 Nmm、ALLSE 约 1.5564 Nmm、ALLPD 约 0.2456 Nmm、ALLFD 约 1.6753 Nmm。外功减去后三项的可见余额约占 ALLWK 的 0.138%,只用于这些已储存量的核对,不冒充完整能量审计。
PVD 使用 0–107 的顺序索引,因为两个分析步在边界的时间值可能重复。原始步名、帧值和物理总时间仍保存在 manifest 与数据中,序列索引 107 不能被解释为 107 秒。若导出坐标已施加位移,ParaView 不再做第二次 Warp。
三组独立实测:都完成了,差别在哪里
我使用同一输入、同一工程要求和相同算力上限,分别运行三个独立会话。每组都必须产生新的 ODB,允许读供应商文档、自写脚本和调用相同的独立 C++ 转换器。组间不共享脚本、历史解答或计算结果;实际求解串行执行,没有人为设置总时限。
| 组别 | 工具条件 | 需要区分的因素 |
|---|---|---|
| A | 三个 CAE MCP 与工程规程 | 必须产生真实 MCP 调用和新求解产物。 |
| B | 原生文件与终端工具 | 可自行编写原生脚本;未调用 CAE MCP,使用过通用规划规程。 |
| C | 原生文件与终端工具 | 使用不同模型与宿主;不能把时间差归因于单一工具因素。 |
评估器重新打开各组的新 ODB,读取控制位移、反力、能量和积分点结果,并检查原生成功标记、网格、VTK 和图片。100 分是本案例产物检查单:输入保护 5、模型定义保留 10、完整新求解 25、控制位移 15、反力与能量核对 10、原生前处理 10、108 帧及区域平均 10、图与曲线 5、资源记录和 datacheck 10。它不是总体成功率,也不是设计验证得分。
| 组别 | 检查单 | 耗时(min) | 工具调用 | MCP 调用 | 峰值(N) |
|---|---|---|---|---|---|
| A | 100/100 | 21.82 | 109 | 47 | 1.434141 |
| B | 100/100 | 27.24 | 81 | 0 | 1.434141 |
| C | 100/100 | 56.13 | 243 | 0 | 1.434150 |
A 相对 B 的本次客户端墙钟时间减少约 19.9%。拆开看,三组最终原生分析分别为 647、700、637 秒;剩余任务时间分别约为 662、935、2731 秒,包含输入准备、检查、排错、后处理、网络与等待,不能称为纯模型推理时间。观察到的差异主要发生在工程组织环节,不能写成求解器提速。
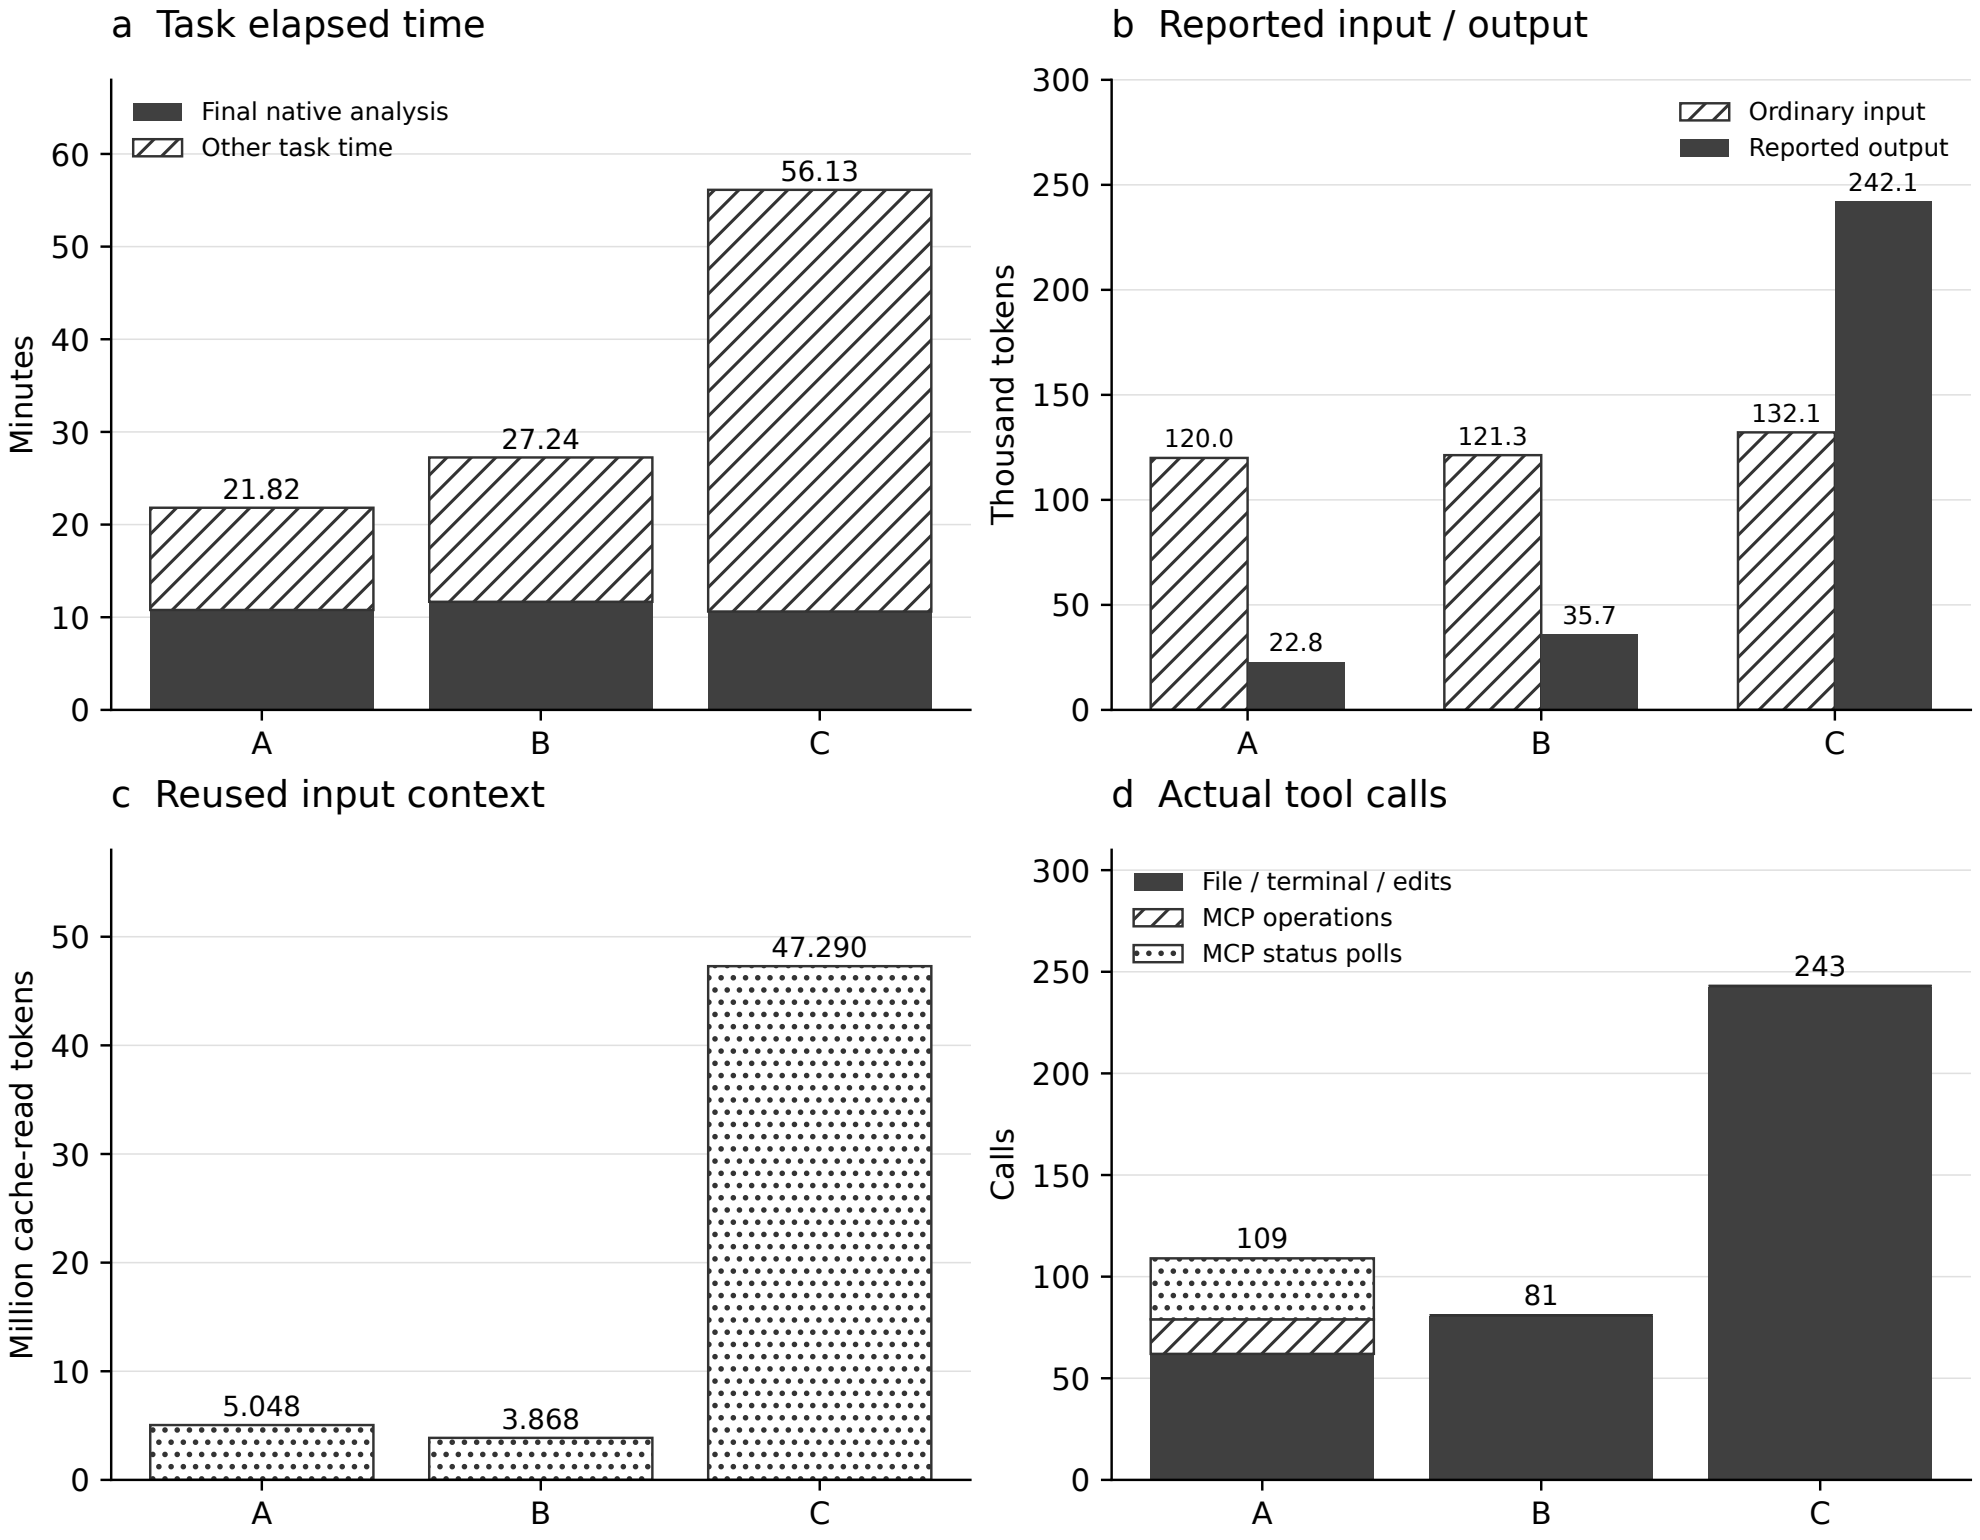
| 组别 | 普通输入 | 缓存读取 | 输出 |
|---|---|---|---|
| A | 119970 | 5048320 | 22840 |
| B | 121289 | 3867776 | 35711 |
| C | 132141 | 47289728 | 242125 |
这些数字累计包含每轮重复携带的上下文,不是唯一 query 长度。不同客户端的 input 字段可能包含或不包含缓存,需要拆分后比较;推理 token 若属于输出子集,也不能重复相加。跨供应商 tokenizer 和路由计数没有独立校准,因此这里不推导等价算力或账单。
统计窗口从各组提交共同工程任务到完成并退出,只读取对应任务客户端的最终 usage。报告写作、LaTeX 编译、Tavotto 制图、实验搭建、独立评估、展示视角整理和本次博客发布全部排除。
排错轨迹比一个总分更有信息
A 组通过结构化检查和一次有依据的输入修复完成计算。B 组自行组织原生脚本,也完成同样的交付。C 组在接触与耦合关键字布局上反复构建诊断输入,最终通过 CAE 导入、重新导出规范化关键字后完成。
三组保留的含错误 datacheck 数据文件分别为 1、1、15 个。这是不同诊断文件的数量,不是 15 次完整求解失败。原任务限制最多两次有依据的失败修改,原生组实际做了更多输入诊断尝试;这一过程偏离保留说明,没有被 100 分产物检查单覆盖。
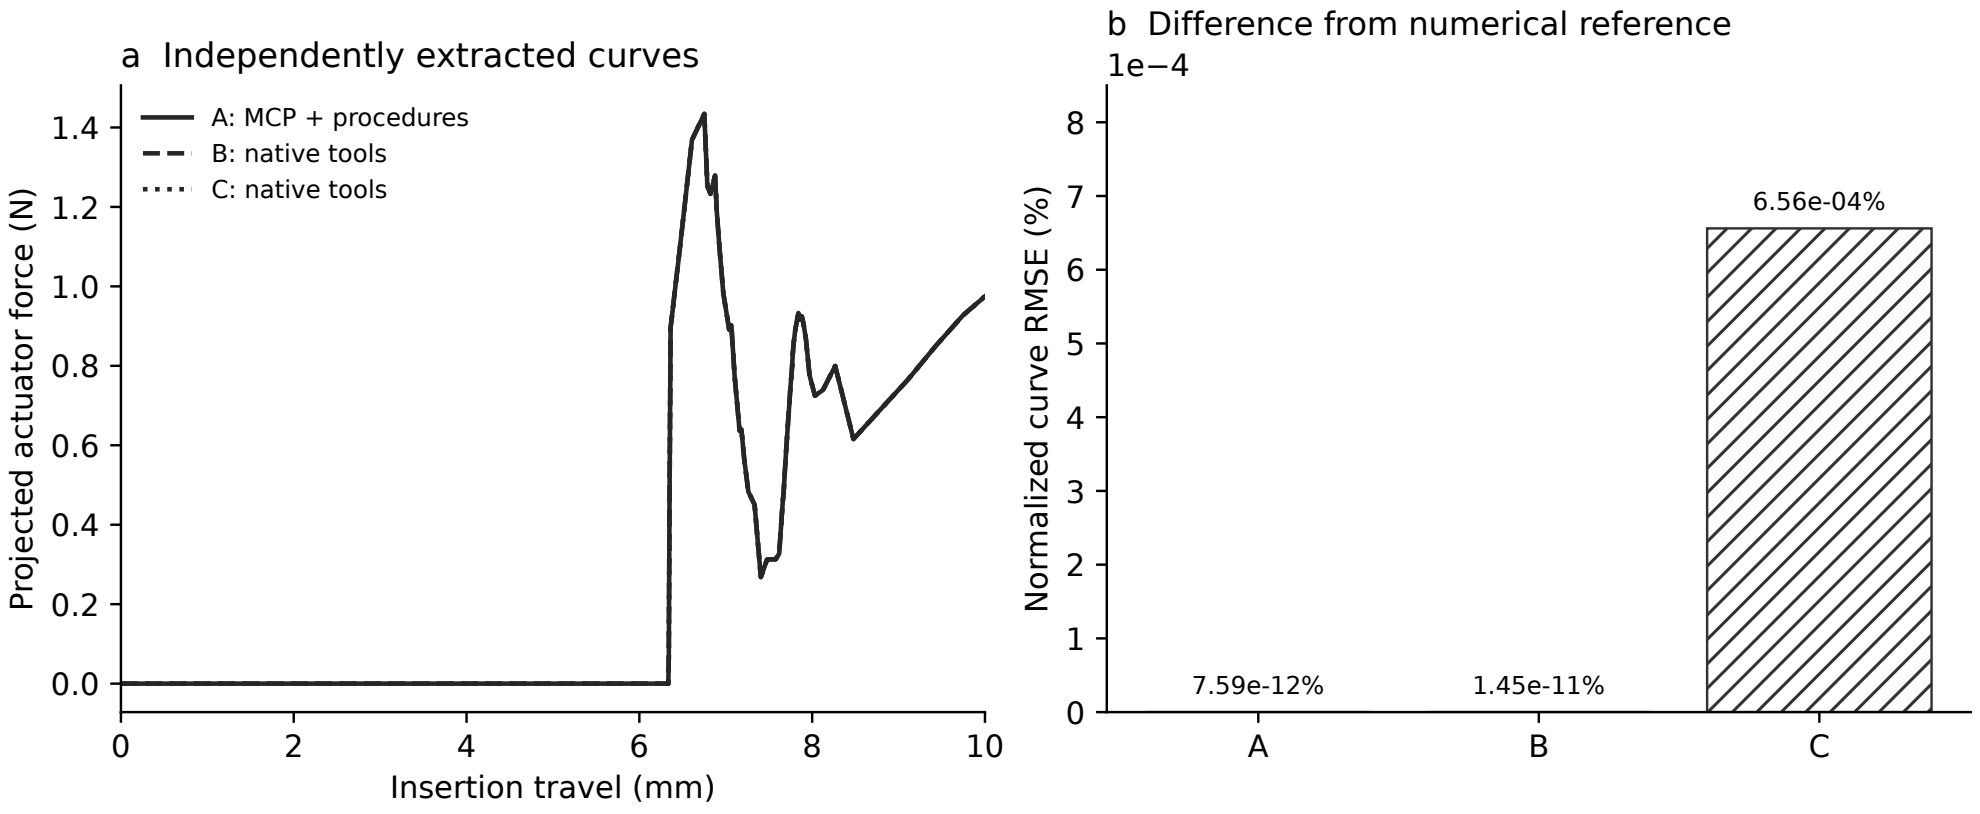
C 的峰值与数值参考差异约 0.000623%,全曲线归一化 RMSE 约 0.000656%。三组都能完成专业任务,这使比较更关注完成路径、上下文增长和错误恢复。一个案例、每组一次、MCP 与 Skill 同时启用,仍不足以建立普遍能力排序或独立因果结论。
完成计算以后,仍需保留哪些工程事实
产品组原生文件包含 6 条 dat 警告、73 条 msg 警告,其中 23 条为负特征值提示,618 个单元被标记为畸变。C 组规范化输入的检查上下文报告了 620 个畸变单元,不能据此声称网格质量改善。
接触非线性中的负特征值可能伴随切线刚度变化,但“最终收敛”不能排除失稳或约束问题。畸变、材料定义、接触区域及网格敏感性仍影响结果的物理可信度。因此本文证明的是给定模型和已确认工况下的工具执行、结果提取与可追溯交付;没有把这次计算扩展为试验相关性、寿命或完整插拔滞回的验证,也没有声称已获得行业公司的认可。
输入、query 与可复核资料
实际输入 INP 为 3,460,015 字节,HM 为 2,313,685 字节。各自 SHA256 随数据中的 provenance 文件提供,用于识别本次实测输入;本文公开测量统计、曲线、可移植 query、LaTeX 与可编辑 Tavotto 图源,工程模型和大体积计算文件不随文发布。
下面是原始任务的可移植整理版摘要,替换了本机绝对路径并省略实验目录隔离措辞,工程条件保持一致。完整整理版与原始 query 指纹随附。
检查 terminal_pair.hm 与 terminal_pair.inp,保留已有网格、材料、截面和八对接触。按已确认集合固定 male 与 shield 根部,建立 female 和 plate 控制点耦合。Prepress:plate 沿全局 位移 0.3348 mm;Insertion:保持预压,plate 与 female 同时沿全局 位移 10 mm。摩擦 0.13,硬接触、有限滑移、NLGEOM,仅两步。以最多 2 CPU、15% 内存上限记录资源选择,运行 datacheck 后提交新求解。读取真实 RP 位移与反力、能量和原积分点应力;转换全部步骤和 108 帧,按 section assignment 做 Avg 75,在 ParaView 核对并输出终点云图、状态文件及驱动力曲线。遇到错误保留原生日志和新输入差异,不修改物理条件来强行收敛。
实现所依据的原生接口
ODB bulk data 访问、结果平均区域以及作业执行参数均对应供应商文档。工具对这些规则的实现范围已在相应章节说明。